Interviews auf dem Mac mit Sprecherkennzeichnung transkribieren
Kennzeichne die Sprecher eines Interviews, prüfe die Zuordnung der Aussagen, korrigiere Namen und exportiere das überprüfte Gespräch.
2026-10-04 · 7 min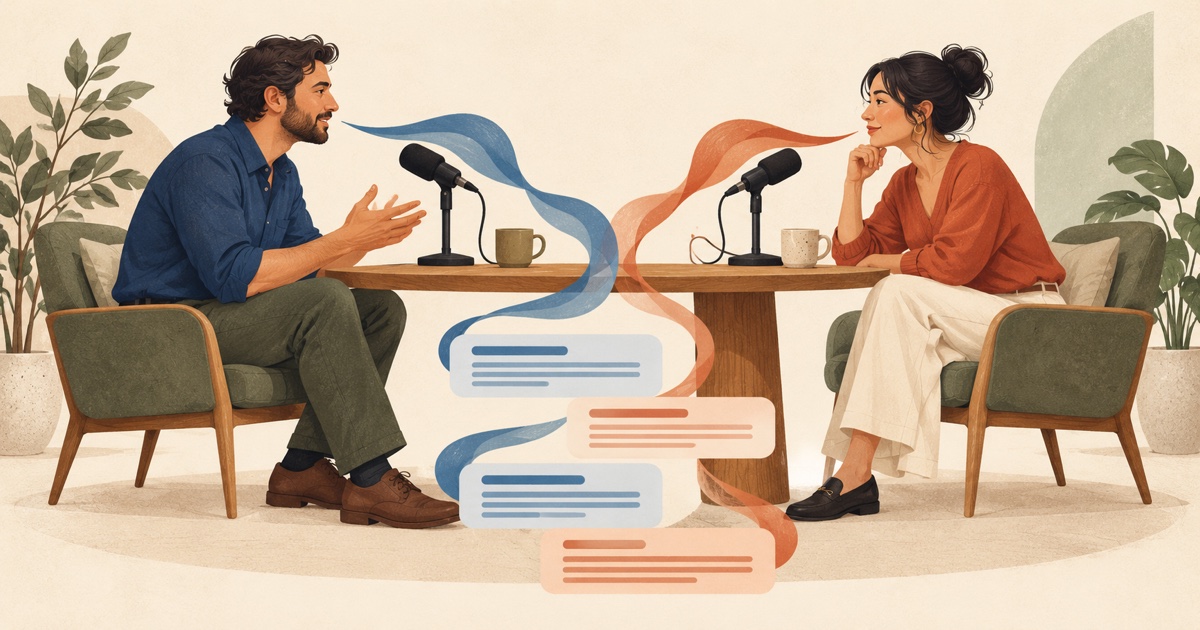
Die kurze Antwort
Um ein Interview zu transkribieren und die sprechenden Personen zu unterscheiden, verwenden Sie die Dateitranskription mit aktivierter Sprecherdiarisierung (Sprecherkennzeichnung). Es fügt Teilen des erkannten Textes Sprecherbezeichnungen hinzu und hilft Ihnen so, eine Frage und ihre Antwort zu überprüfen, ohne die gesamte Aufnahme als eine Stimme zu behandeln. Bereiten Sie die Spracherkennungs- und Rednerressourcen vor, bevor Sie beginnen, und hören Sie dann noch einmal zu, um die Aufgaben zu überprüfen.
Alison Workspace unterstützt diesen Workflow für lesbare Audio- und Videodateien auf einem Apple-Silicon Mac, M1 oder neuer, auf dem macOS 15 oder höher ausgeführt wird. Sie können eine erwartete Anzahl von Sprechern auswählen, das generierte Transkript überprüfen, die Sprecherzuweisung eines Absatzes ändern, Beschriftungen umbenennen und den Text exportieren. Beginnen Sie mit einem klaren Austausch zwischen Interviewer und Gast, anstatt das Ergebnis anhand der Musik oder des Gesprächs mehrerer Personen zu beurteilen.
Was Sprecherkennzeichnungen aussagen
Die Spracherkennung fragt, was gesagt wurde. Beim Sprecherdiarisierung wird abgefragt, welche Stimme während eines Teils der Aufnahme gesprochen hat. Eine Transkription kann korrekte Wörter mit dem falschen Sprecher oder eine korrekte Sprecherbezeichnung an einen falsch erkannten Satz angehängt haben. Überprüfen Sie beide Dimensionen.
Die anfänglichen Kennzeichnungen unterscheiden Stimmen innerhalb dieser Aufnahme. Sie liefern keine automatisch verifizierten Namen und belegen nicht, dass ein Sprecher in einer anderen Datei dieselbe Person ist. Stimmeigenschaften helfen, Sprachabschnitte nach Sprechern zu gruppieren; die tatsächliche Identität muss getrennt bestätigt werden.
Unter Sprechertrennung versteht man in diesem Handbuch beschrifteten Text. Dabei geht es nicht darum, für jeden Teilnehmer eine isolierte Audiodatei zu exportieren oder die Stimme einer Person aus einem sich überschneidenden Austausch zu entfernen. Entscheiden Sie, ob Sie eine lesbare Gesprächsaufzeichnung oder separate Audiospuren benötigen, bevor Sie einen Workflow auswählen.
Eine überprüfbare Interviewaufnahme vorbereiten
Verwenden Sie die beste verfügbare Originalaufnahme mit gut verständlicher Sprache. Vermeiden Sie es, eine komprimierte Kopie zu erstellen, nur um deren Größe zu reduzieren, wenn das Original bereits importiert wird. Ein ruhiger Gast, Hintergrundmusik und Stimmen aus verschiedenen Mikrofonen können den Aufwand für die Ergebniskontrolle erhöhen.
Hören Sie sich zunächst einen kurzen Austausch an. Beachten Sie, wie viele Personen tatsächlich sprechen, einschließlich einer Einleitung oder einer Frage des Produzenten, falls vorhanden. Das Wissen, dass das Hauptinterview zwei Teilnehmer hat, beweist nicht, dass jeder Teil der Akte nur zwei Stimmen hat.
Wenn bereits separate Teilnehmeraufzeichnungen verfügbar sind, bewahren Sie diese als Referenz auf. Der aktuelle Workflow beschriftet die importierte Datei; Es wird nicht beschrieben, wie einzelne Teilnehmerspuren automatisch zu einem synchronisierten Gespräch zusammengeführt werden. Stellen Sie sicher, dass Sie Aufnahmen verwenden, die Sie transkribieren und behalten können.
Sprechertrennung und erwartete Anzahl vorbereiten
Zusätzlich zur Spracherkennung verfügt die Sprechertrennung über weitere Ressourcen. Aktivieren Sie im Dateitranskriptionsfenster von Alison die Option zur Sprechertrennung und folgen Sie der Aufforderung zur Modellbereitschaft. Das Aktivieren einer Einstellung ohne nutzbare Ressourcen ist kein Beweis dafür, dass der endgültige Datensatz Labels enthält.
Das Zählmenü bietet eine automatische Schätzung und bekannte Zählungen von 2 bis 6. Bei einem echten Zwei-Personen-Interview teilt die Auswahl von 2 dem Prozess mit, wie viele Stimmen gruppiert werden sollen. Wenn Sie sich nicht sicher sind, verwenden Sie die Automatik und überprüfen Sie das Ergebnis. Das Menü „Bekannte Anzahl“ ist ein Einstellbereich und keine gemessene Grenze für die Anzahl, die der automatische Modus verarbeiten kann.
Eine Zählung ist eine Orientierungshilfe, keine Garantie. Wenn eine dritte Stimme erscheint oder eine Person das Mikrofon oder den Sprechstil ändert, kann eine falsche feste Zählung dazu führen, dass Passagen schlecht gruppiert werden. Überprüfen Sie die vollständige Aufnahme, anstatt davon auszugehen, dass die Eröffnung jeden Sprecher festlegt.
Die Interviewdatei transkribieren
Wählen Sie die Erkennungssprache für die eigentliche Sprache. Wenn Sie eine Übersetzung benötigen, wählen Sie deren Ziel unabhängig aus und bestätigen Sie, dass das erforderliche Paar verfügbar ist. Sie können die Übersetzung auslassen, während Sie Namen und Sprecherzuordnungen in der Originalsprache überprüfen.
- Fügen Sie die Audio- oder Videodatei des Interviews zur Transkriptionswarteschlange hinzu.
- Überprüfen Sie die Dauer der akzeptierten Datei und wählen Sie die gesprochene Sprache aus.
- Bereiten Sie die erforderlichen Spracherkennungsressourcen vor; Für die automatische Spracherkennung ist ein kompatibles lokales Modell erforderlich.
- Aktivieren Sie die Sprecher-Diarisierung (Sprecher-Kennzeichnung) und bereiten Sie die angeforderten Sprecher-Ressourcen vor.
- Wählen Sie eine bekannte Anzahl von Personen aus, die berechtigterweise sprechen, oder lassen Sie die Automatik eingeschaltet und beginnen Sie dann mit der Transkription.
- Öffnen Sie das Ergebnis und spielen Sie Passagen jedes Teilnehmers noch einmal ab, bevor Sie die Bezeichnungen akzeptieren.
Lassen Sie sich anhand des Status der Datei darüber informieren, ob die Verarbeitung abgeschlossen ist. Wenn das Ergebnis unvollständig ist, überprüfen Sie nur den verarbeiteten Teil und kümmern Sie sich um den fehlenden Rest, bevor Sie ihn als vollständiges Interview präsentieren.
Zuordnungen vor der Namensvergabe korrigieren
Suchen Sie aus jeder Stimme einen klaren Satz und spielen Sie dessen Audio ab. Stellen Sie fest, welches anfängliche Etikett dem Interviewer und welches dem Gast entspricht. Überprüfen Sie auch spätere Passagen: Eine korrekte Eröffnungsbeschriftung beweist nicht, dass alle Sprecherwechsel korrekt gehandhabt wurden.
Wenn ein Absatz falsch zugeordnet ist, rufen Sie den Bearbeitungsmodus des Transkripts auf und wählen Sie den korrekten vorhandenen Sprecher für diesen Absatz aus. Korrigieren Sie die Wörter bei Bedarf separat. Eine Namensänderung gilt für das Label im gesamten Datensatz; Es ist nicht das richtige Werkzeug, um nur einen einzigen falsch beschrifteten Absatz zu verschieben.
Sehr kurze Antworten und Unterbrechungen verdienen Aufmerksamkeit. Ein erkanntes Segment kann einen Sprecherwechsel umfassen und die verfügbaren Timing-Informationen beeinflussen, wie genau es unterteilt werden kann. Gehen Sie nicht davon aus, dass jedes kurze „Ja“ oder jede sich überschneidende Bemerkung eine eigene perfekte Bezeichnung erhält.
Kennzeichnungen nach Prüfung der Stimmen umbenennen
Ersetzen Sie generische Bezeichnungen durch bestätigte Namen oder Rollen wie Interviewer und Gast. Rollen sind nützlich, wenn Sie keine persönlichen Namen benötigen. Achten Sie darauf, dass die Rechtschreibung mit dem Begleitmaterial des Interviews übereinstimmt, anstatt anhand einer automatisch erkannten Einleitung zu raten.
Die Sprechernamen-Steuerelemente aktualisieren die vom Datensatz und seinen Exporten verwendeten Bezeichnungen. Spielen Sie eine benannte Passage noch einmal ab, um zu bestätigen, dass eine globale Namensänderung nicht dazu geführt hat, dass der Name des Gastes dem Interviewer zugeordnet wurde. Wenn eine echte Stimme in mehrere Bezeichnungen aufgeteilt wurde, überprüfen Sie deren Passagen, bevor Sie denselben Namen zuweisen.
Durch das Umbenennen eines Labels wird Ihre redaktionelle Entscheidung dokumentiert. Es handelt sich nicht um eine Sprachauthentifizierung und es wird kein automatisches Identitätsprofil für zukünftige Dateien erstellt. Überprüfen Sie unabhängig die Labels einer neuen Aufnahme.
Ein nachvollziehbares Gespräch exportieren
Wählen Sie TXT, Markdown, PDF oder CSV für ein lesbares oder wiederverwendbares Dokument. Wenn Sprecherbezeichnungen vorhanden sind, aktivieren Sie die Option zum Einbeziehen von Sprechern. Behalten Sie Zeitstempel bei, wenn der Leser zur Aufzeichnung zurückkehren muss. Die Auswahlmöglichkeiten für den Original-, übersetzten und zweisprachigen Export hängen vom im Datensatz verfügbaren Text ab.
SRT und VTT stehen auch für einen Untertitel-Workflow zur Verfügung und beinhalten immer die erforderliche Zeitachse. Überprüfen Sie die beabsichtigte Anzeige, bevor Sie eine Untertiteldatei teilen: Ein nützliches Interviewdokument und eine komfortable Video-Untertitelspur erfordern unterschiedliche Formatierungsentscheidungen.
Hören Sie sich Namen, Zitate, Zahlen, Zusagen und unsichere Zuschreibungen noch einmal an, bevor Sie etwas teilen. Ein vom Sprecher gekennzeichneter Entwurf hilft Ihnen beim Auffinden dieser Passagen. es macht ein ungeprüftes Angebot nicht zuverlässig.
Probleme mit Sprecherkennzeichnungen prüfen
Wenn keine Beschriftungen angezeigt werden, überprüfen Sie, ob die Sprecherdialogisierung (Sprecherkennzeichnung) aktiviert und die entsprechenden Ressourcen bereit sind. Die Erkennung kann Text erzeugen, während die optionale Lautsprecherstufe keine verwertbaren Aufgaben bereitstellt. Ein erfolgreiches Textergebnis und eine erfolgreiche Sprecherkennzeichnung sind nicht derselbe Status.
Wenn die Beschriftungen falsch sind, überprüfen Sie die Zähleinstellung und den Ton erneut. Ähnliche Stimmen, entfernte Sprache, Änderungen im Mikrofonton, Hintergrundgeräusche und sich überschneidende Gespräche können die Gruppierung erschweren. Nutzen Sie klare Passagen als Anker, korrigieren Sie, was Sie überprüfen können, und lassen Sie unsichere Zuschreibungen sichtbar, anstatt Gewissheit zu erfinden.
Sobald die Ressourcen bereit sind, werden die unterstützten Erkennungs- und Sprecherarbeiten lokal auf Ihrem Mac ausgeführt. Bewahren Sie die Quelldatei zur Überprüfung auf und wählen Sie ein beabsichtigtes Ziel für das exportierte Transkript. Der nächste sinnvolle Schritt ist ein klarer Interviewaustausch mit Labels, die Sie persönlich überprüft haben.
Offizielle Referenzen geprüft am 4. Oktober 2026
Microsoft: diarization and generic speaker identifiers
Amazon Transcribe: speaker labels and timestamps
FluidAudio: on-device speaker diarization framework
Häufig gestellte Fragen
Sollte ich für ein Zwei-Personen-Interview einen automatischen Sprecher oder zwei Sprecher wählen?
Wählen Sie 2, wenn genau zwei Personen in der Datei sprechen. Wenn durch Einführungen oder Unterbrechungen weitere Stimmen hinzugefügt werden, verwenden Sie eine Zählung, die die Aufnahme widerspiegelt, oder versuchen Sie es mit der Automatik und überprüfen Sie die Zuweisungen.
Identifiziert die Sprecherdiarisierung (Sprecherkennzeichnung) automatisch die Namen von Personen?
Nein, es werden Sprachbezeichnungen innerhalb der Aufnahme zugewiesen. Bestätigen Sie die Personen oder Rollen selbst und benennen Sie dann die Bezeichnungen im Sprachprotokoll um.
Kann ich korrigieren, wer einen Absatz gesagt hat?
Ja. Mit dem Transkript-Editor können Sie die Zuordnung eines Absatzes zu einem vorhandenen Sprecher ändern. Durch das Umbenennen eines Sprechers ändert sich stattdessen die Bezeichnung im gesamten Datensatz.
Warum hat eine Person zwei Etiketten erhalten?
Die Stimmgruppierung kann durch kurzes Sprechen, Geräusche, unterschiedliche Mikrofone oder Änderungen in der Übermittlung beeinträchtigt werden. Spielen Sie die relevanten Passagen noch einmal ab, bevor Sie entscheiden, ob die Bezeichnungen derselben Person gehören.
Kann ich die isolierte Stimme jeder Person exportieren?
Diese Funktion beschriftet Transkripttext. Es ist kein separater Audio-Track-Export für jeden Sprecher möglich und es werden auch keine überlappenden Stimmen entfernt.
Werden die Namen der Sprecher im exportierten Dokument angezeigt?
Aktivieren Sie „Sprecher einbeziehen“, wenn der Datensatz Labels hat. Beim Export werden bestätigte Namen verwendet. Überprüfen Sie das ausgewählte Dokument- oder Untertitelformat, bevor Sie es freigeben.
Wird dieselbe Sprechernummer dieselbe Person in einer anderen Datei identifizieren?
Nein, behandeln Sie die Beschriftungen in jeder Aufnahme unabhängig voneinander. Der hier beschriebene Workflow stellt keine dateiübergreifende Stimmidentität her.