Transcrire un entretien avec des étiquettes de locuteur sur Mac
Ajoutez des étiquettes de locuteur à un entretien, vérifiez chaque attribution, corrigez les noms et exportez la conversation relue.
2026-10-04 · 7 min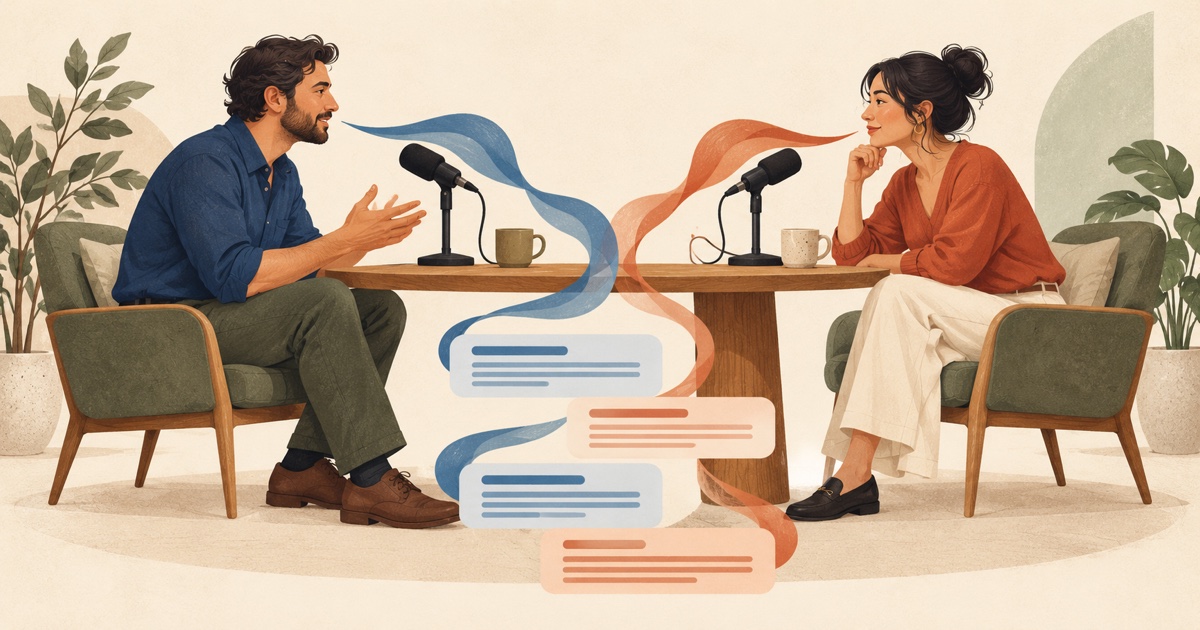
La réponse courte
Pour transcrire une interview et distinguer les personnes qui parlent, utilisez la transcription de fichiers avec la diarisation des locuteurs (étiquetage des locuteurs) activée. Il ajoute des étiquettes de locuteur à des parties du texte reconnu, vous aidant ainsi à réviser une question et sa réponse sans traiter l'ensemble de l'enregistrement comme une seule voix. Préparez les ressources de reconnaissance et de conférencier avant de commencer, puis réécoutez pour vérifier les devoirs.
Alison Workspace prend en charge ce flux de travail pour les fichiers audio et vidéo lisibles sur un Apple-silicon Mac, M1 ou version ultérieure, exécutant macOS 15 ou version ultérieure. Vous pouvez sélectionner un nombre prévu de personnes parlant, consulter la transcription générée, modifier l'attribution des locuteurs d'un paragraphe, renommer les étiquettes et exporter le texte. Commencez par un échange clair entre l’intervieweur et l’invité plutôt que de juger le résultat à partir de la musique ou de plusieurs personnes discutant ensemble.
Ce que les étiquettes de locuteur indiquent
La reconnaissance vocale demande ce qui a été dit. La diarisation du locuteur demande quelle voix a parlé pendant une partie de l'enregistrement. Une transcription peut contenir des mots corrects avec le mauvais locuteur, ou une étiquette de locuteur correcte attachée à une phrase mal reconnue. Examinez les deux dimensions.
Les étiquettes initiales distinguent les voix dans cet enregistrement. Elles ne fournissent pas automatiquement de noms vérifiés et ne prouvent pas qu’une personne dans un autre fichier est la même. Les caractéristiques vocales aident à regrouper les passages par locuteur ; vérifier l’identité réelle est une tâche distincte.
Dans ce guide, la séparation des locuteurs signifie un texte étiqueté. Il ne s'agit pas d'exporter un fichier audio isolé pour chaque participant ou de supprimer la voix d'une personne lors d'un échange qui se chevauche. Décidez si vous avez besoin d'un enregistrement de conversation lisible ou de pistes audio séparées avant de choisir un flux de travail.
Préparer un enregistrement que vous pouvez vérifier
Utilisez le meilleur enregistrement original disponible, avec une parole facile à entendre. Évitez de faire une copie compressée simplement pour réduire sa taille si l'original est déjà importé. Un invité silencieux, une musique de fond et des voix provenant de différents microphones peuvent augmenter le travail nécessaire pour vérifier le résultat.
Écoutez d’abord un court échange. Notez combien de personnes parlent réellement, y compris une introduction ou une question du producteur s'il est présent. Savoir que l’entretien principal compte deux participants ne prouve pas que chaque partie du dossier n’a que deux voix.
Si des enregistrements distincts des participants sont déjà disponibles, conservez-les comme références. Le flux de travail actuel étiquette le fichier importé ; il ne décrit pas la fusion automatique des pistes de participants distinctes dans une conversation synchronisée. Assurez-vous que vous utilisez des enregistrements que vous pouvez transcrire et conserver.
Préparer la diarisation et le nombre de personnes
La séparation des locuteurs dispose de ressources en plus de la reconnaissance vocale. Dans la fenêtre de transcription de fichier d’Alison, activez l'option haut-parleur et suivez son invite de préparation du modèle. Activer un paramètre sans ressources utilisables ne prouve pas que l'enregistrement final contiendra des étiquettes.
Le menu de décompte propose une estimation automatique et des décomptes connus de 2 à 6. Pour un entretien véritablement à deux, le choix de 2 indique au processus le nombre de voix à regrouper. Si vous n'êtes pas sûr, utilisez automatique et inspectez le résultat. Le menu de comptage connu est une plage de réglage et non une limite mesurée du nombre que le mode automatique peut gérer.
Un décompte est une indication, pas une garantie. Si une troisième voix apparaît, ou si une personne change de microphone ou de style de parole, un décompte fixe incorrect peut mal regrouper les passages. Vérifiez l’enregistrement complet plutôt que de supposer que l’ouverture établit chaque orateur.
Transcrire le fichier de l’entretien
Choisissez la langue de reconnaissance pour le discours réel. Si vous avez besoin d'une traduction, sélectionnez sa cible indépendamment et confirmez que la paire souhaitée est disponible. Vous pouvez désactiver la traduction tout en vérifiant les noms et les affectations des intervenants dans la langue d'origine.
- Ajoutez le fichier audio ou vidéo de l'interview à la file d'attente de transcription.
- Vérifiez la durée du fichier accepté et sélectionnez la langue parlée.
- Préparer les ressources de reconnaissance requises ; la détection automatique de la langue nécessite un modèle local compatible.
- Activez la diarisation des locuteurs (étiquetage des locuteurs) et préparez les ressources des locuteurs demandées.
- Choisissez un nombre connu de personnes parlant lorsque cela est justifié, ou laissez-le en automatique, puis lancez la transcription.
- Ouvrez le résultat et rejouez les passages de chaque participant avant d'accepter les étiquettes.
Laissez l'état du fichier vous indiquer si le traitement est terminé. Si le résultat est partiel, examinez uniquement la partie traitée et traitez le reste manquant avant de le présenter comme un entretien complet.
Corriger les attributions avant d’ajouter des noms
Localisez une phrase claire de chaque voix et écoutez son audio. Déterminez quelle étiquette initiale correspond à l’intervieweur et laquelle correspond à l’invité. Vérifiez également les passages ultérieurs : une étiquette d'ouverture correcte ne prouve pas que tous les changements de locuteur ont été traités correctement.
Lorsqu'un paragraphe est mal attribué, entrez dans le mode d'édition de la transcription et choisissez le bon locuteur existant pour ce paragraphe. Corrigez les mots séparément si nécessaire. Un changement de nom s'applique au label dans tout le document ; ce n'est pas le bon outil pour déplacer un seul paragraphe mal étiqueté.
Les réponses très courtes et les interruptions méritent attention. Un segment reconnu peut couvrir un changement de locuteur, et les informations de synchronisation disponibles affectent la précision avec laquelle il peut être divisé. Ne présumez pas que chaque bref « oui » ou chaque remarque qui se chevauche recevra sa propre étiquette parfaite.
Renommer les étiquettes après avoir confirmé les voix
Remplacez les étiquettes génériques par des noms ou des rôles confirmés tels que Intervieweur et Invité. Les rôles sont utiles lorsque vous n'avez pas besoin de noms personnels. Gardez l'orthographe cohérente avec le matériel d'accompagnement de l'entretien plutôt que de deviner à partir d'une introduction automatiquement reconnue.
Les contrôles de nom de locuteur mettent à jour les étiquettes utilisées par l'enregistrement et ses exportations. Rejouez un passage nommé pour confirmer qu'un changement de nom global n'a pas attaché le nom de l'invité à l'intervieweur. Lorsqu'une vraie voix a été divisée en plusieurs labels, vérifiez leurs passages avant d'attribuer le même nom.
Renommer une étiquette enregistre votre décision éditoriale. Il ne s'agit pas d'une authentification vocale et ne crée pas de profil d'identité automatique pour les futurs fichiers. Examinez les étiquettes d’un nouvel enregistrement de manière indépendante.
Exporter une conversation facile à vérifier
Choisissez TXT, Markdown, PDF ou CSV pour un document lisible ou réutilisable. Là où des étiquettes de haut-parleurs existent, activez l'option permettant d'inclure des haut-parleurs ; conservez les horodatages si le lecteur doit revenir à l’enregistrement. Les choix d'exportation originaux, traduits et bilingues dépendent du texte disponible dans le dossier.
SRT et VTT sont également disponibles pour un flux de travail de sous-titres et incluent toujours leur axe temporel requis. Vérifiez l'affichage prévu avant de partager un fichier de sous-titres : un document d'interview utile et une piste de sous-titres vidéo confortable nécessitent des décisions de formatage différentes.
Réécoutez les noms, les citations, les chiffres, les engagements et les attributions incertaines avant de les partager. Un brouillon étiqueté par le locuteur vous aide à trouver ces passages ; cela ne rend pas fiable une cotation non contrôlée.
Examiner les problèmes d’attribution
Si aucune étiquette n'apparaît, vérifiez que la diarisation des locuteurs (étiquetage des locuteurs) a été activée et que ses ressources sont prêtes. La reconnaissance peut produire du texte tandis que l'étage de haut-parleur en option ne fournit aucune affectation utilisable. Un résultat de texte réussi et un étiquetage réussi du locuteur ne sont pas le même statut.
Si les étiquettes sont erronées, revisitez le paramètre de comptage et l'audio. Des voix similaires, des paroles distantes, des changements dans le son du microphone, des bruits de fond et des conversations qui se chevauchent peuvent rendre le regroupement difficile. Utilisez des passages clairs comme points d'ancrage, corrigez ce que vous pouvez vérifier et laissez visible l'attribution incertaine plutôt que d'inventer la certitude.
Une fois les ressources prêtes, le travail de reconnaissance et de haut-parleur pris en charge s'exécute localement sur votre Mac. Conservez le fichier source pour examen et choisissez une destination intentionnelle pour la transcription exportée. La prochaine étape utile est un échange d’entretien clair avec des labels que vous avez personnellement vérifiés.
Références officielles vérifiées le 4 octobre 2026
Microsoft: diarization and generic speaker identifiers
Amazon Transcribe: speaker labels and timestamps
FluidAudio: on-device speaker diarization framework
Questions fréquemment posées
Dois-je choisir un système automatique ou 2 haut-parleurs pour un entretien à deux ?
Choisissez 2 lorsque exactement deux personnes parlent dans le fichier. Si les introductions ou les interruptions ajoutent d'autres voix, utilisez un décompte qui reflète l'enregistrement ou essayez l'automatique et révisez les affectations.
La diarisation des locuteurs (étiquetage des locuteurs) identifie-t-elle automatiquement les noms des personnes ?
Non, il attribue des étiquettes vocales dans l'enregistrement. Confirmez vous-même les personnes ou les rôles, puis renommez les étiquettes dans la transcription du discours.
Puis-je corriger qui a dit un paragraphe ?
Oui. L'éditeur de transcription vous permet de modifier l'attribution d'un paragraphe à un locuteur existant. Renommer un locuteur modifie plutôt cette étiquette tout au long de l'enregistrement.
Pourquoi une personne a-t-elle reçu deux étiquettes ?
Le regroupement des voix peut être affecté par des paroles courtes, du bruit, des microphones différents ou des changements dans la diffusion. Relisez les passages pertinents avant de décider si les étiquettes appartiennent à la même personne.
Puis-je exporter la voix isolée de chaque personne ?
Cette fonctionnalité étiquette le texte de la transcription. Il ne fournit pas d'exportation de piste audio distincte pour chaque locuteur et ne supprime pas les voix qui se chevauchent.
Les noms des intervenants apparaîtront-ils dans le document exporté ?
Activez Inclure les haut-parleurs lorsque l’enregistrement comporte des étiquettes. Les noms confirmés sont utilisés dans l'exportation. Vérifiez le document ou le format de sous-titre choisi avant de le partager.
Le même numéro de locuteur identifiera-t-il la même personne dans un autre fichier ?
Non, traitez les étiquettes de chaque enregistrement indépendamment. Le flux de travail décrit ici n’établit pas d’identité vocale entre fichiers.