Macでインタビューを話者別に文字起こしする方法
インタビューに話者ラベルを付け、各発言の人物を確認し、割り当てと名前を修正して書き出す手順を紹介します。
2026-10-04 · 7 min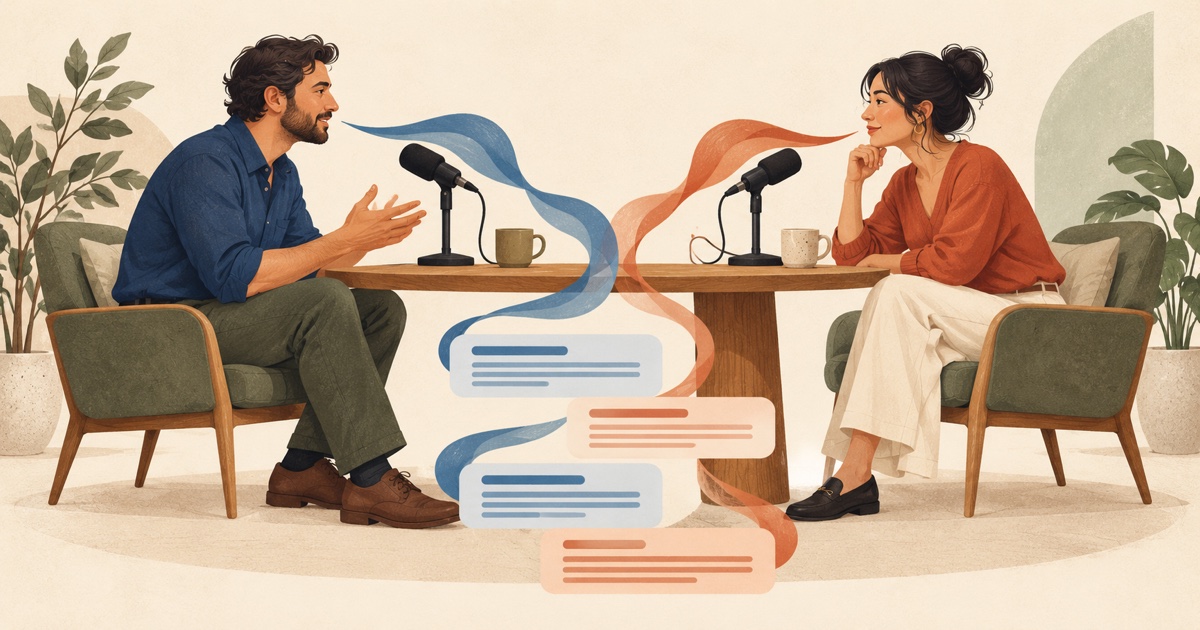
まず結論
インタビューを文字に起こし、話している人物を区別するには、話者分離 (話者のラベル付け) を有効にしてファイルの文字起こしを使用します。認識されたテキストの一部に話者ラベルが追加されるため、録音全体を 1 つの音声として扱うことなく、質問とその回答を確認することができます。開始する前に認識リソースとスピーカー リソースを準備し、再度聞いて割り当てを確認します。
Alison Workspace は、macOS 15 以降を実行する Apple シリコン Mac、M1 以降で読み取り可能なオーディオおよびビデオ ファイルに対してこのワークフローをサポートします。予想される発言者数の選択、生成された文字起こしテキストの確認、段落の話者の割り当ての変更、ラベル名の変更、およびテキストのエクスポートを行うことができます。音楽や複数人の会話から結果を判断するのではなく、インタビュアーとゲストの間の明確なやりとりから始めてください。
話者ラベルで分かること
音声認識は、何を言ったかを尋ねます。話者分離では、録音の一部の間にどの声が話したかを尋ねます。文字起こしテキストには、間違った話者による正しい単語が含まれたり、誤って認識された文に正しい話者ラベルが付けられたりすることがあります。両方の次元を確認してください。
最初のラベルは、その録音内の声を区別するものです。確認済みの実名を自動で示したり、別のファイルの話者が同一人物だと証明したりはしません。声の特徴を使って発言を話者ごとに分類しますが、実際の人物の特定は別の作業です。
このガイドにおける話者の分離とは、ラベル付きテキストを意味します。これは、参加者ごとに分離された音声ファイルをエクスポートしたり、発言が重なった会話から 1 人の音声を削除したりすることを意味するものではありません。ワークフローを選択する前に、読み取り可能な会話記録が必要か、それとも別個の音声トラックが必要かを決定してください。
確認できるインタビュー録音を用意する
聞き取りやすい音声で、入手可能な最高のオリジナル録音を使用します。オリジナルがすでにインポートされている場合は、サイズを減らすためだけに圧縮コピーを作成することは避けてください。静かなゲスト、BGM、さまざまなマイクからの音声により、結果を確認するために必要な作業が増加する可能性があります。
まずは短いやりとりを聞いてください。紹介やプロデューサーの質問がある場合はそれも含めて、実際に何人の人が話しているかに注目してください。メインのインタビューに 2 人の参加者がいることがわかっても、ファイルのすべての部分に 2 つの音声しか含まれていないことは証明されません。
別の参加者の記録がすでに利用可能な場合は、それらを参照として保存してください。現在のワークフローは、インポートされたファイルにラベルを付けます。個別の参加者のトラックを同期された会話に自動的に結合することについては説明しません。文字に起こして保存できる録音を使用していることを確認してください。
話者分離と想定人数を準備する
話者の分離には、音声認識以外にもリソースがあります。 Alison のファイル文字起こしウィンドウで、話者オプションを有効にし、モデルの準備のプロンプトに従います。使用可能なリソースがない状態で設定をオンにしても、最終文字起こし文書にラベルが含まれるという証拠にはなりません。
カウント メニューには、自動推定と 2 ~ 6 の既知のカウントが表示されます。純粋に 2 人によるインタビューの場合、2 を選択すると、グループ化する声の数がプロセスに指示されます。よくわからない場合は、自動を使用して結果を調べてください。既知のカウント メニューは設定範囲であり、自動モードが処理できる数の測定された制限ではありません。
数値は目安であり、保証するものではありません。 3 番目の声が現れた場合、または 1 人がマイクや話し方を変更した場合、固定カウントが正しくないとパッセージが正しくグループ化されない可能性があります。オープニングがすべての話者を確立すると仮定するのではなく、完全な録音を確認してください。
インタビューをファイルから文字起こしする
実際の音声の認識言語を選択します。翻訳が必要な場合は、そのターゲットを個別に選択し、必要なペアが利用可能であることを確認してください。元の言語で名前と話者の割り当てを確認している間、翻訳をオフのままにすることができます。
- インタビューの音声ファイルまたはビデオ ファイルを文字起こしキューに追加します。
- 受け入れられたファイルの長さを確認し、音声言語を選択します。
- 必要な認識リソースを準備します。自動言語検出には互換性のあるローカル モデルが必要です。
- 話者分離 を有効にし、要求された話者のリソースを準備します。
- 必要に応じて既知の発言者数を選択するか、自動のままにして、文字起こしを開始します。
- ラベルを受け入れる前に、結果を開いて各参加者のパッセージを再生します。
ファイルのステータスから、処理が完了したかどうかがわかります。結果が部分的な場合は、完全なインタビューとして提示する前に、処理された部分のみを確認し、不足している残りの部分に対処します。
名前を付ける前に話者の割り当てを修正する
各音声から明確な文を見つけて、その音声を再生します。どの最初のラベルがインタビュアーに対応し、どのラベルがゲストに対応するかを確立します。後のパッセージもチェックしてください。開始ラベルが正しいからといって、話者の変更がすべて正しく処理されたことは証明されません。
段落が正しく割り当てられていない場合は、文字起こしテキストの編集モードに入り、その段落に対して正しい既存の話者を選択します。必要に応じて単語を個別に修正します。名前の変更は文字起こし文書全体のラベルに適用されます。これは、ラベルが間違っている 1 つの段落だけを移動するのに適したツールではありません。
非常に短い返信や中断には注意が必要です。認識されたセグメントは話者の変化にまたがる場合があり、利用可能なタイミング情報はセグメントをどの程度正確に分割できるかに影響します。すべての短い「はい」や重複した発言が、それぞれ完璧なラベルを貼られると考えないでください。
声を確認してラベルの名前を変更する
一般的なラベルを、インタビュアーやゲストなどの確認された名前または役割に置き換えます。役割は、個人名が必要ない場合に便利です。自動的に認識された導入文から推測するのではなく、インタビューの付属資料とスペルの一貫性を保ってください。
話者名コント役割は、文字起こし文書とそのエクスポートで使用されるラベルを更新します。名前付きのパッセージを再生して、全体的な名前の変更によってゲストの名前がインタビュアーに関連付けられていないことを確認します。 1 つの肉声が複数のラベルに分割されている場合は、同じ名前を付ける前に、各部分を確認してください。
ラベルの名前を変更すると、編集上の決定が記録されます。これは音声認証ではなく、将来のファイル用に自動 ID プロファイルを作成しません。新しい録音のラベルを個別に確認します。
後から確認しやすい会話を書き出す
読み取り可能または再利用可能なドキュメントの場合は、TXT、Markdown、PDF、または CSV を選択します。発言者ラベルが存在する場合は、発言者を含めるオプションを有効にします。リーダーが記録に戻る必要がある場合は、タイムスタンプを保持します。オリジナル、翻訳、およびバイリンガルのエクスポートの選択肢は、文字起こし文書内で利用可能なテキストによって異なります。
SRT および VTT は字幕ワークフローにも使用でき、必要な時間軸が常に含まれます。字幕ファイルを共有する前に、意図した表示を確認してください。有用なインタビュー ドキュメントと快適なビデオ字幕トラックでは、異なる形式の決定が必要です。
共有する前に、名前、引用、数字、約束、不確かな帰属をもう一度聞いてください。講演者のラベルが付けられたドラフトは、これらの文章を見つけるのに役立ちます。チェックされていない見積もりが信頼できるものになるわけではありません。
ラベルの問題を調べる
ラベルが表示されない場合は、話者分離 (話者のラベル付け) が有効になっていて、そのリソースの準備ができていることを確認してください。認識によりテキストが生成される一方で、オプションのスピーカー ステージでは使用可能な割り当てが提供されません。テキスト結果の成功と話者のラベル付けの成功は同じステータスではありません。
ラベルが間違っている場合は、カウント設定と音声を見直してください。似たような声、遠くの会話、マイクの音の変化、背景雑音、重複した話などにより、グループ化が困難になることがあります。明確な文章をアンカーとして使用し、検証できるものは修正し、確実性をでっち上げるのではなく、不確かな帰属を見えるようにしておきます。
リソースの準備が完了すると、サポートされる認識とスピーカーの作業が Mac 上でローカルに実行されます。レビュー用にソース ファイルを保存し、エクスポートされた文字起こしテキストの意図的な保存先を選択します。次に役立つステップは、個人的にチェックしたレーベルとの明確なインタビューのやり取りです。
公式参照は 2026 年 10 月 4 日に確認済み
Microsoft: diarization and generic speaker identifiers
Amazon Transcribe: speaker labels and timestamps
FluidAudio: on-device speaker diarization framework
よくある質問
2 人で行うインタビューの場合、自動スピーカーまたは 2 つのスピーカーを選択する必要がありますか?
ファイル内でちょうど 2 人が話している場合は、2 を選択します。導入や中断によって他の音声が追加される場合は、録音を反映するカウントを使用するか、自動で試して割り当てを確認してください。
話者分離 (話者ラベル付け) は人の名前を自動的に識別しますか?
いいえ、録音内に音声ラベルが割り当てられます。人物や役割を自分で確認し、文字起こしテキスト内のラベルの名前を変更します。
誰が発言したかを一段落訂正してもいいでしょうか?
はい。文字起こしテキスト エディタを使用すると、段落の既存の話者への割り当てを変更できます。スピーカーの名前を変更すると、代わりに文字起こし文書全体のラベルが変更されます。
なぜ 1 人が 2 つのラベルを受け取ったのでしょうか?
音声のグループ化は、短いスピーチ、ノイズ、異なるマイク、または配信の変化によって影響を受ける可能性があります。ラベルが同じ人物に属しているかどうかを判断する前に、関連する文章を再生してください。
各人の分離した音声をエクスポートできますか?
この機能は、文字起こしテキストのテキストにラベルを付けます。スピーカーごとに個別のオーディオ トラックをエクスポートしたり、重複する音声を削除したりすることはありません。
スピーカー名はエクスポートされたドキュメントに表示されますか?
文字起こし文書にラベルがある場合は、スピーカーを含めるを有効にします。確認された名前がエクスポートに使用されます。共有する前に、選択したドキュメントまたは字幕の形式を確認してください。
同じ発言者番号は、別のファイルでも同じ人物を識別しますか?
いいえ、各録音のラベルを個別に扱います。ここで説明するワークフローでは、ファイル間の音声 ID は確立されません。